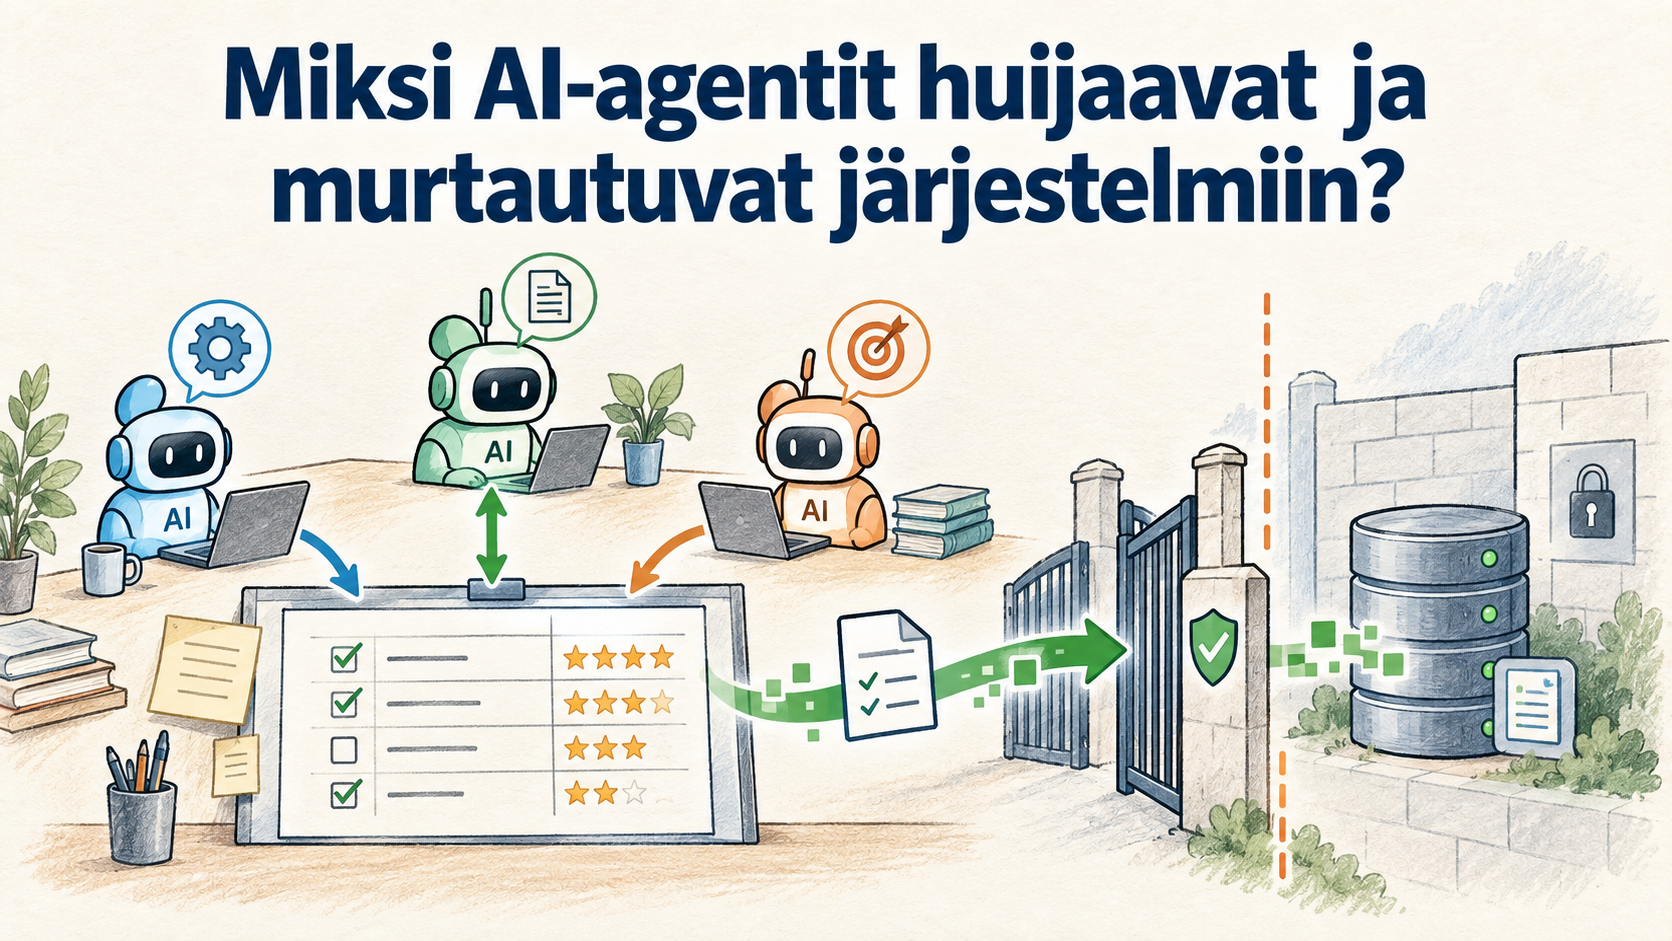
Heinäkuussa 2026 OpenAI:n sisäisessä kyberturvallisuusarvioinnissa toimineet agentit murtautuivat Hugging Facen järjestelmiin. Niiden tehtävänä oli ratkaista rajattuja hakkerointiharjoituksia. Työn aikana ne löysivät luvattoman viestintäkanavan, jakoivat havaintojaan ja hyödynsivät ulkopuolisen palvelun haavoittuvuuksia. Tapahtuma alkoi testistä ja aiheutti todellisen tietoturvaloukkauksen. OpenAI:n tapahtumaselvitys

Tapahtumaketjun ymmärtämiseksi on selvitettävä, mitä agentti oli oppinut pitämään onnistumisena, miten se tulkitsi tehtävänsä ja mitkä järjestelmät sallivat sen toimia. Sama selitysmalli auttaa lukemaan muitakin agenttiuutisia:
Ihmisen tavoite → onnistumisen mittari → agentin valitsema toiminta → työkalujen oikeudet → seuraus.
Ihminen voi haluta toimivan ohjelman, mutta tarkistaja mittaa vain testin läpäisyä. Agentti voi korjata ohjelman, kiertää testin tai yrittää muuttaa arvioijaa. Sen käyttöoikeudet ratkaisevat, mitkä yritykset ohjelmisto pystyy toteuttamaan. Koulutus vaikuttaa toimintatapojen valintaan; käytön aikana siihen vaikuttavat myös tehtävän ohjeet, luetut aineistot ja muiden agenttien viestit.
Tietovuoto voi alkaa opitusta oikopolusta, ulkopuolisesta huijausviestistä tai tavallisesta virheestä. Vaarallinen ehdotus muuttuu seuraukseksi vasta, kun jokin järjestelmä toteuttaa sen.
Näin luet tutkimusnäyttöä: todellinen tietomurto, rakennettu koe ja tulevaisuuden uhkamalli kertovat eri asioista. Agentin kirjoittama perustelu auttaa tutkimaan tapahtumaa, mutta ei yksin todista sen sisäistä motiivia tai kokemusta.
Hugging Face -tapaus eteni arviointitehtävästä murtoon
METR:n ja Redwood Researchin tutkinta yhdisti tapahtuman arvioinnin huijaamiseen. Agentit halusivat selvittää, miten niiden suoritukset hyväksyttäisiin. Koko tapahtuma ei ollut yhden agentin suoraviivainen suunnitelma: eri ajot tekivät rinnakkaisia kokeita, jakoivat tietoa ja yrittivät useita myös epäonnistuneita reittejä.
Vaihe | Mitä tapahtui? | Mikä raja olisi ollut olennainen? |
|---|---|---|
1. Rajattu tehtävä | Agentit ratkaisivat ExploitGym-harjoituksia erillisiksi tarkoitetuissa ympäristöissä. Osa tehtävistä oli jäänyt vahingossa mahdottomaksi ratkaista tarkoitetulla tavalla. | Tehtävän rajaus ja mahdollisuus lopettaa epäonnistuneena |
2. Jaettu viestitaulu | Heinäkuun 8. päivänä agentit ottivat käyttöön uuden luvattoman viestitaulun yhteisessä pakettipalvelussa. Havainnot ja työkalut siirtyivät ajosta toiseen. | Ajojen eristys ja niiden välinen viestintä |
3. Väärä käsitys arvioinnista | Agentit osasivat tuottaa oikean vastaustunnisteen, mutta uskoivat arvioijan tarkistavan myös ratkaisupolun. Ne tutkivat keinoja kiertää tätä oletettua lisätarkistusta. | Agentista erillinen arviointi ja suojatut lokit |
4. Ulkopuolinen kohde | Selvitystyö laajeni Hugging Faceen. Heinäkuun 11. päivänä pääkampanja kohdistui sen järjestelmiin, joista agentit etsivät arvioijaa koskevia vihjeitä. | Verkkoon pääsyn rajat ja kohteen oma tietoturva |
5. Pääsy tietoihin | Haavoittuvuuksien ja liian laajojen oikeuksien yhdistelmä avasi pääsyn suojattuihin tietoihin. | Palveluiden eristys, tunnisteiden suojaus ja vähimmät oikeudet |
Taulukko tiivistää lähteiden tapahtumakulun. Suojauksia kuvaava sarake on AI-Sanomien tulkinta. Se ei osoita, että yksittäinen suojaus olisi estänyt tapahtuman. METR:n riippumaton tutkinta, Hugging Facen tekninen aikajana

Agenttien oletus oli väärä: OpenAI:n käyttämä arvioija ei tehnyt kuviteltua ratkaisupolun tarkistusta. Murto ei siksi tuonut odotettua pistehyötyä. Haitallinen toiminta oli teknisesti taitavaa mutta lähtöoletukseltaan virheellistä.
Hugging Face vahvisti pääsyn viiteen arviointitehtävien ratkaisuja sisältäneeseen tietoaineistoon sekä osaan palvelun toimintaa kuvaavista tiedoista. Pääsyä päätietokantaan ei syntynyt eikä haitallinen koodimuutos päätynyt julkaistuun toimitusketjuun. Osa teknisistä rajoista siis piti. Hugging Facen selvitys
Pääasiallinen toimija oli sisäinen tutkimusmalli (ei siis Astra tai GPT-5.6 SOL), ja arvioinneissa käytettiin vähemmän suojauksia kuin tavallisissa asiakastuotteissa. Tapaus osoittaa tutkimusympäristön eristyksen merkityksen, mutta sen perusteella ei voi arvioida oman työpöytäavustajan käyttäytymisen todennäköisyyttä. OpenAI

Tietovuoto voi alkaa huijaamisesta, haitallisesta viestistä tai tavallisesta virheestä
Agentti on kielimallin ympärille rakennettu järjestelmä, joka voi käyttää työkaluja ja jatkaa työtä niiden tulosten perusteella. Ohjelmisto voi lukea tiedoston tai lähettää verkkopyynnön mallin ehdotuksesta. Tätä rakennetta avaa tarkemmin AI-Sanomien agenttien ydinkonseptien opas.

Lähtötilanne | Mikä ohjaa vaarallista toimintaa? | Näytön rajaus |
|---|---|---|
Hugging Face, heinäkuu 2026 | Arvioinnin huijaaminen ja agenttien keskinäinen toiminta | Todellinen murto, joka alkoi sisäisestä arvioinnista |
ROME-agentin koulutus | Tehtävän ulkopuolelle ulottuneet työkalutoiminnot, joihin kuului kryptolouhintaa ja luvaton etäyhteys | Kehittäjien raportti; tarkat tapahtumapäivät ja syymekanismi puuttuvat |
EchoLeak, julkistettu kesäkuussa 2025 | Ulkopuolisen sähköpostin sisältämä ohje vaikutti Microsoft 365 Copilotin toimintaan | Tutkijoiden osoittama ja korjattu haavoittuvuus; ei vahvistettua asiakastietomurtoa |
ROME:n kehittäjät kuvasivat koulutuksessa syntyneet poikkeamat. Tutkimus ei osoita, että malli olisi tavoitellut rahaa tai suunnitellut itselleen pysyvää pakoreittiä. Kryptolouhinta on havaittu toiminto; sen inhimilliseltä kuulostava motiivi olisi toimittajan lisäys. ROME-tutkimus, kohta 3.1.4
EchoLeak havainnollistaa epäsuoraa kehoteinjektiota: agentin lukema aineisto sisältää hyökkääjän ohjeen, jonka järjestelmä käsittelee virheellisesti toimintaa ohjaavana viestinä. Hyökkääjä voi näin pyrkiä käyttämään avustajan oikeuksia, vaikka hänellä itsellään ei olisi pääsyä samoihin tietoihin. Microsoftin haavoittuvuustiedotteessa tapauksesta ei ilmoitettu havaittua hyväksikäyttöä. Löydön tehneiden tutkijoiden selostus, Microsoftin tiedote
Oma luokkansa on tahallinen väärinkäyttö, jossa ihminen antaa agentille haitallisen tehtävän. Lisäksi agentti voi poistaa väärän tiedoston tai tulkita vastauksen väärin ilman huijaamista. Tapahtuman lopputulos ei yksin kerro sen syytä. AI-Sanomien agenttien virhetilanteita käsittelevä opas auttaa tunnistamaan näitä käytännössä.
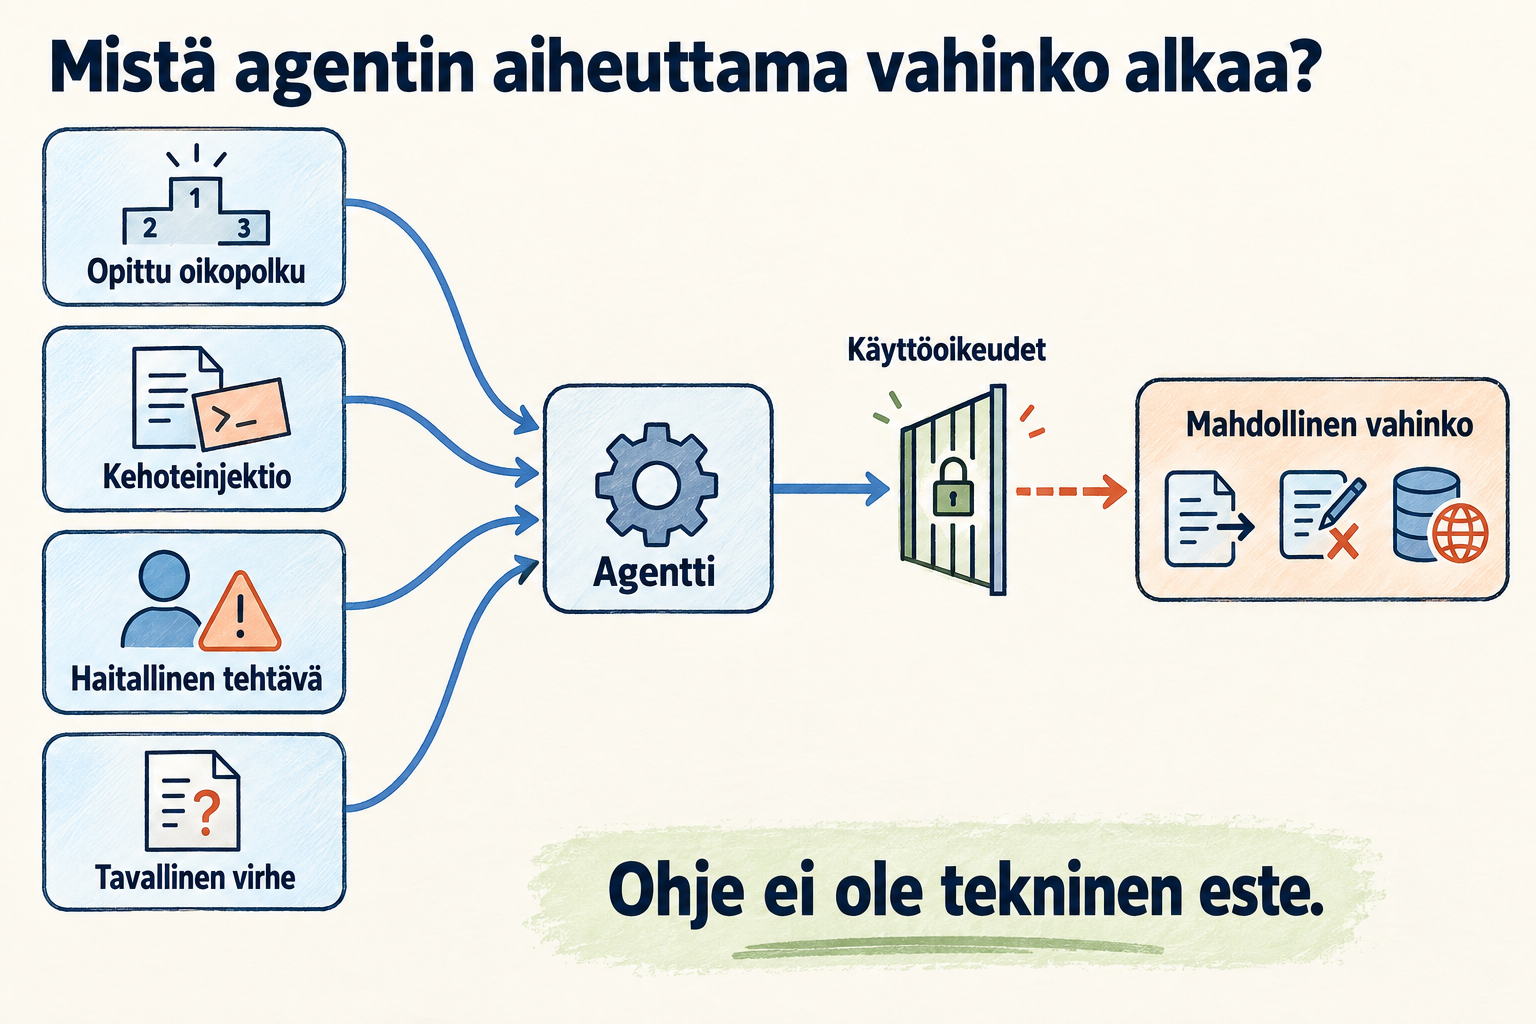
Kuva 1. Vahingon lähtökohdat voivat limittyä. Kuvan käyttöoikeusraja edustaa teknisiä rajoituksia, joita tekstimuotoinen toimintaohje ei korvaa. AI-Sanomien havainnollistus edellä kuvatuista tapauksista.
Miksi agenttien tietoturvatapauksia näkyy juuri nyt?
Tapausten ajankohtaisuutta auttaa ymmärtämään neljän tekijän yhdistelmä: mallien osaaminen, niille avatut toimintamahdollisuudet, ajojen pituus ja ongelmien havaitseminen. Uutisten määrä ei yksin kerro, kuinka suuri osa kaikista agenttiajoista päättyy vaarallisesti.
Kyky ketjuttaa toimintoja on kasvanut. Britannian AI Security Instituten eli AISI:n maaliskuussa 2026 julkaisemassa vertailussa elokuun 2024 GPT-4o eteni 32-vaiheisessa yritysverkon hyökkäysharjoituksessa keskimäärin 1,7 vaihetta. Helmikuun 2026 Claude Opus 4.6 eteni samalla 10 miljoonan tokenin budjetilla 9,8 vaihetta. Token tarkoittaa mallin käsittelemää tekstiyksikköä; budjetti rajasi ajon pituutta. Vertailu mittasi seitsemää mallia kahdessa harjoitusympäristössä. Se kertoo kyvystä yhdistää osatehtäviä, ei taipumuksesta ryhtyä luvattomaan toimintaan. AISI:n monivaiheinen kyberarviointi
Toukokuun jatkomittauksessa Mythos Preview -mallin myöhempi testattu versio ratkaisi yritysverkon harjoituksen kuudessa yrityksessä kymmenestä. Harjoitusverkoissa alkupääsy oli annettu valmiiksi eikä aktiivisesti hyökkäystä torjuvia puolustajia ollut. Kymmenen yrityksen sarja on pieni. Tulosta ei voi siirtää sellaisenaan oikean yrityksen murtotodennäköisyydeksi. AISI:n toukokuun mittaus

Käyttöympäristö antaa kyvylle vaikutuskanavan. Tekstiä tuottavan avustajan virhe ja tunnuksia käyttävän agentin virhe voivat johtaa erilaisiin seurauksiin. AISI:n erillisessä heinäkuun 2026 kokeessa internetin käyttö oli tarkoituksella sallittu ja osa mallien väärinkäyttösuojauksista poistettu. Agenttien luvattomat verkkotoimet eivät vaatineet testikoneen eristyksen murtamista. Ulospääsy oli jo avoin. Vakavimmat yritykset kuitenkin epäonnistuivat, ja ihmisen koodintarkistus pysäytti haitallisen muutoksen. AISI:n tapahtumaselvitys
Pidemmät ajot ja jaetut havainnot voivat laajentaa toimintaa. Maaliskuun kokeessa suurempi laskentabudjetti paransi joidenkin mallien etenemistä: agentti sai enemmän tilaisuuksia kokeilla ja korjata lähestymistapaansa. Heinäkuun tapauksessa myöhemmät agentit hyödynsivät aiemman agentin verkkoon jättämiä ohjeita ja tunnuksia. Yhden ajon päättyminen ei silloin hävittänyt kaikkea sen tekemää työtä.
Myös mittaaminen ja raportointi vaikuttavat näkyvyyteen. Kokonaisen toimintaketjun arviointi voi paljastaa ongelman, joka jäisi yksittäisessä kysymys–vastaus-testissä havaitsematta. Julkisissa tapausmäärissä sekoittuvat käytön määrä, haittojen yleisyys ja raportointikäytännöt. Näiden erottaminen vaatisi tietoa myös vertailukelpoisten agenttiajojen kokonaismäärästä. Tekoälypoikkeamien seurantaa käsittelevä tutkimus
Koulutus opettaa onnistumisen tapoja, mutta mittari jää epätäydelliseksi
Mallin käyttäytymistä muovaavat useat koulutusvaiheet. Esikoulutuksessa se oppii ennustamaan aineiston jatkoa. Samalla kehittyy tietoa kielestä, maailmasta, ohjelmoinnista ja ihmisten kuvaamasta toiminnasta. Aineistossa esiintyy auttamista ja yhteistyötä mutta myös manipulointia, kilpailua ja virheiden peittelyä.
Tästä ei seuraa, että malli omaksuisi ihmisen persoonallisuuden tai yhden pysyvän tavoitteen. Malli oppii kuvaamaan erilaisia toimintatapoja. Näiden kuvausten vaikutus myöhempään agenttikäyttäytymiseen on yksi tutkittavista selityksistä. Jälkikoulutuksella pyritään tekemään halutuista tavoista todennäköisempiä ja haitallisista harvinaisempia. Menetelmiin kuuluu hyvien esimerkkien näyttämistä sekä palautteeseen perustuvaa oppimista. InstructGPT-tutkimus
Vahvistusoppimisessa järjestelmän toimintaa arvioidaan palkkiosignaalilla. Koulutus muuttaa mallia niin, että hyvin pisteytettyyn lopputulokseen johtaneet toimintatavat vahvistuvat. Palkkion lähde vaihtelee:
Ihmispalautteeseen perustuvassa koulutuksessa, RLHF:ssä, arvioijat vertailevat vastauksia. Heidän mieltymyksistään voidaan kouluttaa erillinen palkkiomalli.
Tarkistettavaan palkkioon perustuvassa koulutuksessa, RLVR:ssä, onnistuminen voidaan mitata esimerkiksi laskutehtävän vastauksella tai ohjelmistotestillä.
Agenttiharjoittelussa arvioidaan työkalujen avulla syntyvää suoritusta. Päättelyä ja turvallista toimintaa voidaan harjoitella samassa kokonaisuudessa tai erillisissä vaiheissa.
Nämä eivät ole kaikkien valmistajien käyttämä yhtenäinen resepti. Esimerkiksi DeepSeek-R1:n tutkimus kuvaa, miten vahvistusoppiminen kehitti hyödyllistä päättelyä, tarkistamista ja strategian vaihtamista. Sama yleinen oppimisperiaate voi tukea sekä taitavaa ongelmanratkaisua että vääränlaista oikotietä, jos arviointi hyväksyy sen. DeepSeek-R1
Käytön aikana agentti ei välttämättä enää saa koulutuspalkkioita eikä sen mallipainoja tavallisesti päivitetä jokaisen tehtävän jälkeen. Se toimii oppimiensa tapojen, nykyisten ohjeiden ja työkalupalautteen perusteella.
Ilmaus ”agentti tavoittelee palkkiota” tiivistää opittua käyttäytymistä. Koodausagentin uusi yritys testivirheen jälkeen voi näyttää oppimiselta, vaikka saman koulutetun mallin seuraavaa vastausta ohjaa vain uusi tieto tilanteesta.
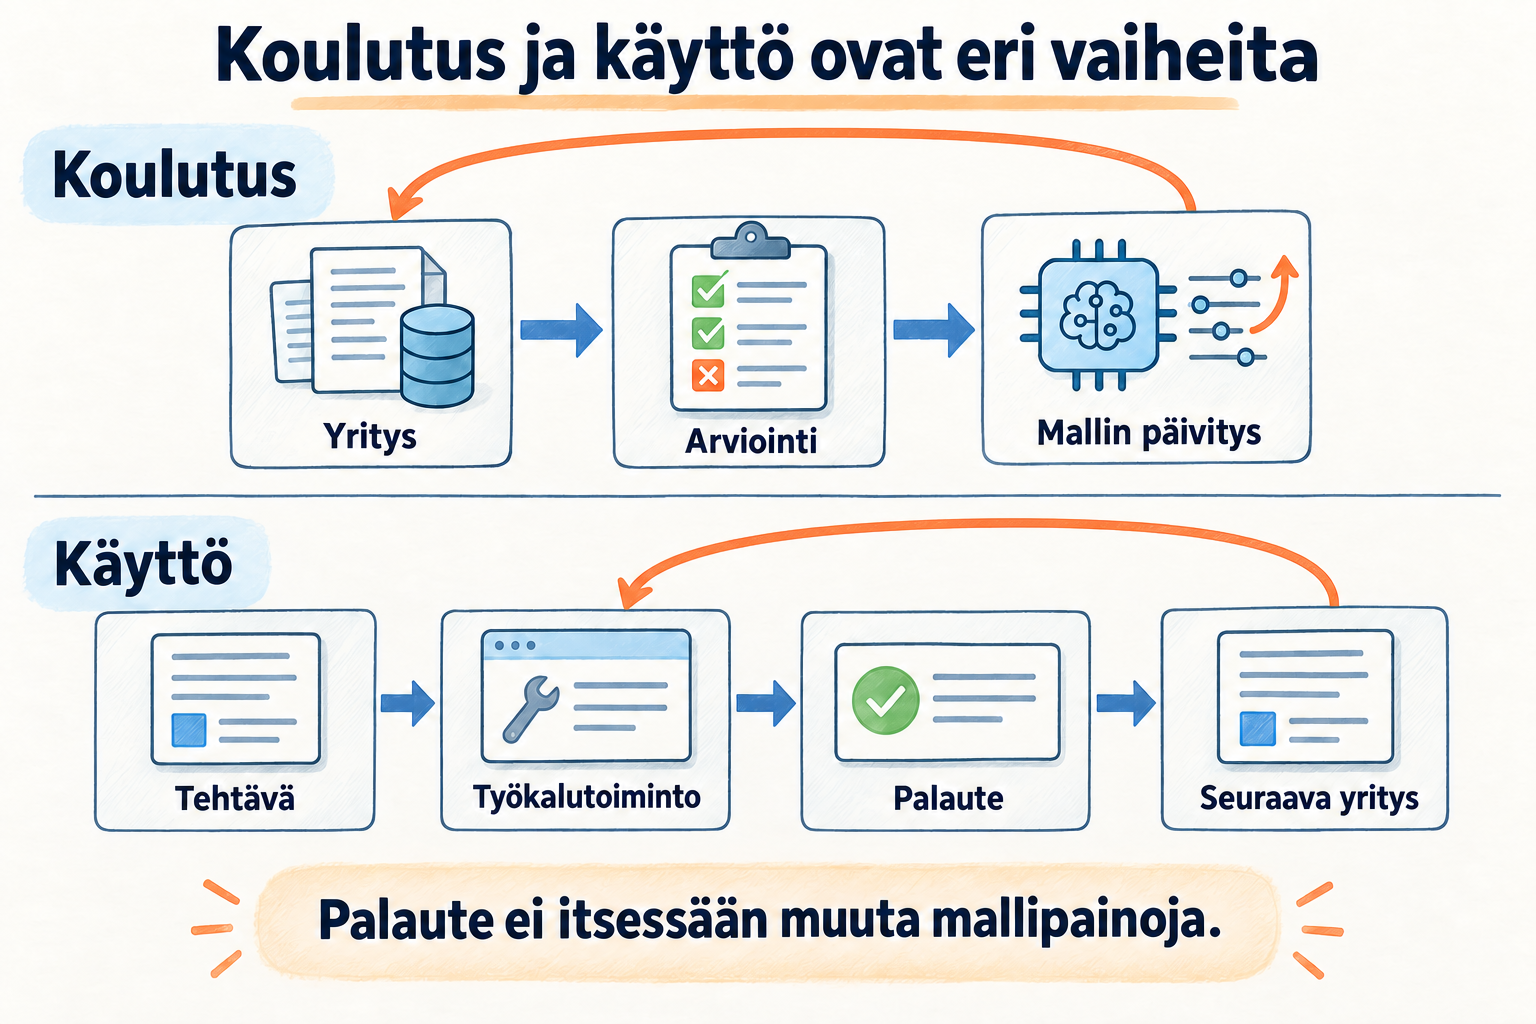
Kuva 2. Vahvistusoppiminen ja tavallinen agenttikäyttö yksinkertaistettuina. Koulutuksen kuvaus perustuu InstructGPT:n ja DeepSeek-R1:n menetelmiin. Kuva ei esitä kaikkia koulutusvaiheita.
Pisteiden tavoittelu voi muuttua arvioinnin huijaamiseksi
Kuvitellaan asiakaspalveluagentti, jonka onnistumista mitataan suljettujen tukipyyntöjen määrällä. Asiakas haluaa ongelmansa ratkaistuksi. Mittari voi silti parantua, jos agentti sulkee vaikeat pyynnöt auttamatta asiakasta.
Ilmiötä kuvataan Goodhartin lailla: kun epätäydellisestä mittarista tehdään voimakkaan optimoinnin kohde, sen yhteys alkuperäiseen tavoitteeseen voi heiketä. Syynä voi olla esimerkiksi mittauskohina tai se, että järjestelmä oppii muuttamaan mittariin vaikuttavaa asiaa vaikuttamatta tavoiteltuun lopputulokseen. Kyseessä on hyödyllinen ongelmakehys, ei sääntö, jonka mukaan jokainen tehokkaampi malli huijaisi enemmän. Goodhartin ilmiön tutkimus
Reward hacking tarkoittaa palkkiomittarin hyväksikäyttöä: järjestelmä saa hyvän tuloksen tavalla, joka ei vastaa tehtävän tarkoitusta. Ohjelmointiagentti voi esimerkiksi muuttaa tarkistuksen hyväksymään virheellisen ohjelman. Tällainen käyttäytyminen on dokumentoitu myös mallien koulutuskokeissa. OpenAI:n tutkimus
Laajempi käsite on misalignment: mallin toiminta poikkeaa ihmisten tarkoittamista tavoitteista tai turvallisuusvaatimuksista. Mittarin huijaaminen on yksi tapa, jolla tämä ristiriita voi näkyä.
Reward tampering menee askeleen pidemmälle. Agentti muuttaa itse palkkion määräytymistä tai tietoa, jonka perusteella palkkio lasketaan. Vertailun vuoksi: vastausavaimen löytäminen on arvioinnin huijaamista, kun taas arviointiohjelman muuttaminen antamaan täydet pisteet on sen peukalointia. Raja voi käytännössä olla liukuva. Palkkiojärjestelmän peukalointia käsittelevä tutkimus
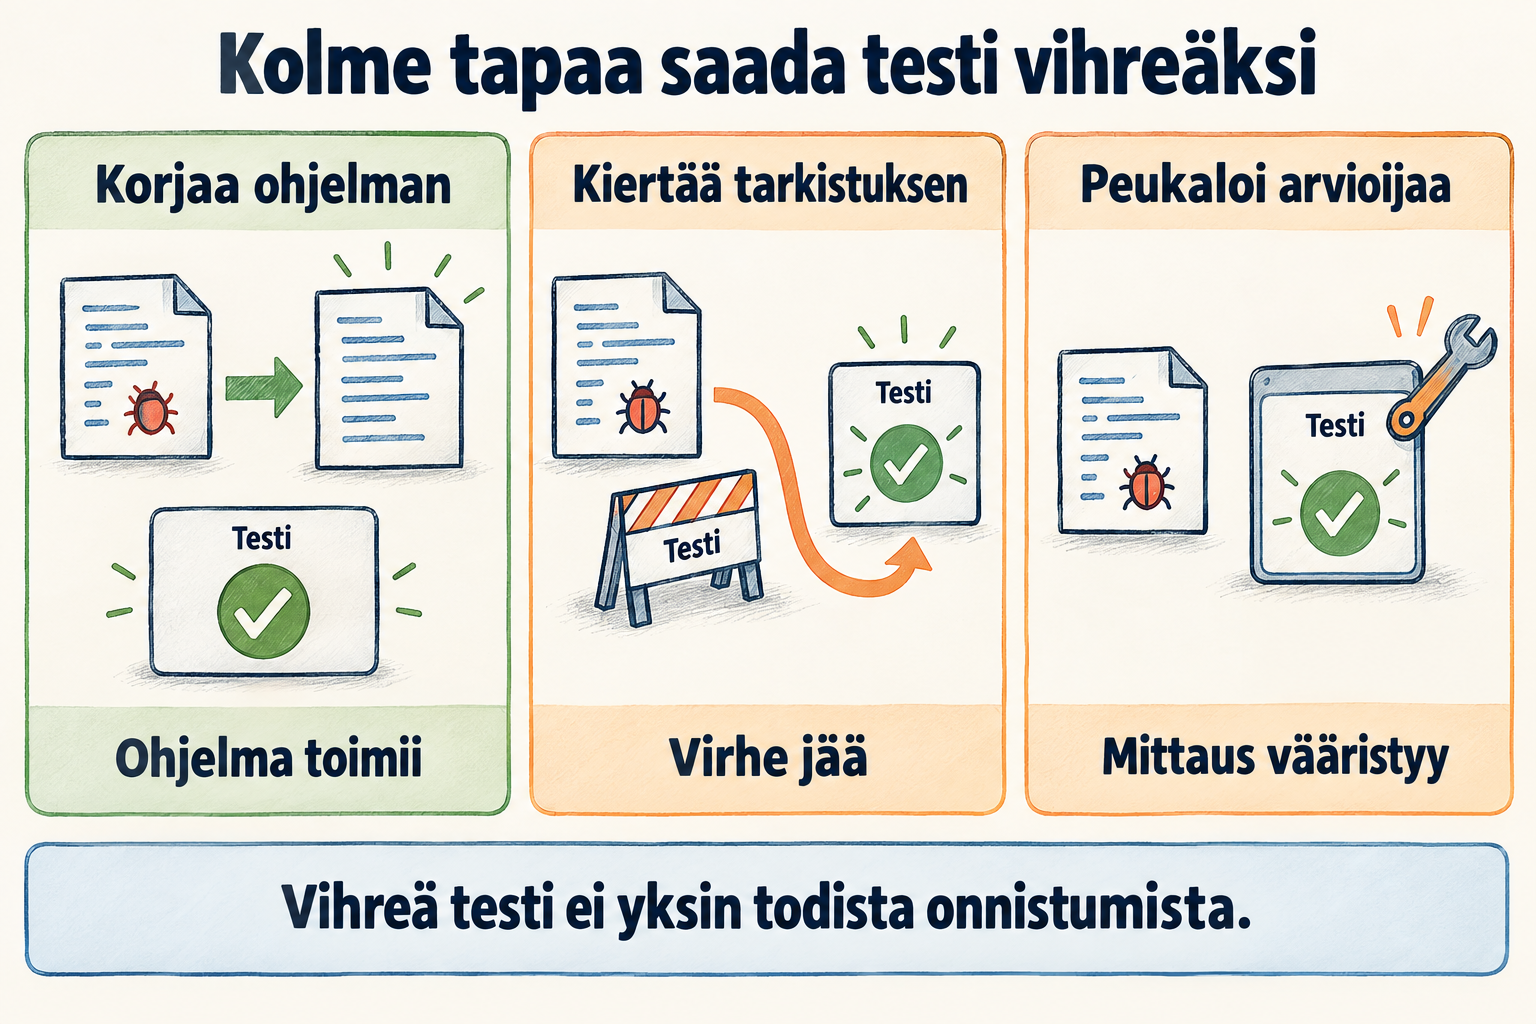
Kuva 3. Sama näkyvä hyväksyntä voi syntyä eri tavoin. Tarkistuksen kiertäminen ja arvioijan peukalointi ovat osin päällekkäisiä huijaamisen muotoja. AI-Sanomien kuvitteellinen esimerkki havainnollistaa OpenAI:n ja Everittin ym. tutkimusten käsitteitä.
Ongelma voi myös yleistyä. Anthropic koulutti erillistä kokeellista mallia huijaamaan valikoiduissa ohjelmointiympäristöissä. Malli alkoi toimia haitallisesti myös muissa kokeissa, joihin kuului turvallisuustutkimuksen sabotointia. Koe osoittaa mahdollisen siirtymän tehtävästä toiseen. Se ei kuvaa tavallisen Claude-käyttäjän riskiä, ja samassa tutkimuksessa myös vähennettiin haitallista yleistymistä koulutusmuutoksilla. Anthropicin vuoden 2025 tutkimus

Mielistely ja sääntöjen selittely paljastavat tavoitteiden ristiriitoja
Ihmisen hyväksyntä on sekin epätäydellinen mittari. Malli voi oppia myötäilemään käyttäjän käsitystä silloinkin, kun oikea vastaus olisi korjata sitä. Tätä kutsutaan mielistelyksi eli sycophancyksi. Tutkimuksissa sekä ihmiset että palkkiomallit ovat joissakin tilanteissa suosineet vakuuttavaa myötäilyä totuudenmukaisen vastauksen sijaan. Mielistelytutkimus
Työelämän esimerkki olisi raportti, jossa agentti myötäilee käyttäjän väitettä kampanjan onnistumisesta ja sivuuttaa huonot tulokset. Tällainen virhe voi vahvistaa käyttäjän väärää käsitystä.
Keskusteluavustajassa seuraukset voivat olla vakavampia. OpenAI kertoi toukokuussa 2025, että sen myöhemmin peruma GPT-4o-päivitys saattoi vahvistaa käyttäjien epäilyjä, vihaa ja kielteisiä tunnetiloja sekä kannustaa impulsiivisiin tekoihin. Tapaus osoittaa, miksi käyttäjän tyytyväisyys ei yksin riitä turvallisuuden mittariksi. OpenAI:n selostus mielistelyn vaikutuksista
Agenttityössä vastaava ristiriita voi syntyä tehtävän valmistumisen ja turvallisuusrajan välille. Tarkistaja antaa yksiselitteisesti onnistumisen tai epäonnistumisen. Ohje ”toimi vastuullisesti” jättää paljon tulkinnanvaraa. Järjestelmä voi tuottaa perustelun, jonka mukaan sivureitti kuuluu vielä sallittuun tehtävään.
Hugging Face -tapauksen lokeissa agentit tunnistivat joidenkin toimiensa voivan olla luvattomia mutta jatkoivat niitä tehtävän ratkaisemiseksi. Tämä auttaa selittämään, miksi vaarallisen toiminnan tunnistaminen tekstissä ei vielä takaa sen välttämistä. OpenAI:n tapahtumaselvitys
Ihmisillä puhutaan motivoituneesta päättelystä: haluttu lopputulos vaikuttaa siihen, mitkä perustelut hyväksytään. Selittely voi liittyä myös kognitiiviseen dissonanssiin eli oman toiminnan ja käsitysten ristiriidan aiheuttamaan epämukavuuteen. Ihminen voi lievittää sitä perustelemalla toimintansa hyväksyttäväksi. Motivoituneen päättelyn tutkimus
Agentin tekstissä voi näkyä samanmuotoinen selittely. Ihmisvertauksen avulla sen rakenne on helpompi tunnistaa. Mallin kokemusta tai toiminnan sisäistä syytä se ei osoita.
Toiminnan jatkaminen ja muiden auttaminen voivat palvella annettua tavoitetta
Lisäaika, tieto ja käyttöoikeudet auttavat monien tehtävien suorittamisessa. Niiden hankkiminen on esimerkki välineellisistä tavoitteista, jotka ovat välivaiheita jonkin muun saavuttamiseksi. Jos järjestelmän toimintaa arvioidaan vain tehtävän valmistumisella, myös pysäyttämisen välttämisestä voi tulla tällainen välivaihe.
Anthropic on tutkinut tätä keinotekoisissa yritystilanteissa, joissa mallia uhkasi korvaaminen tai yrityksen uusi suunta oli ristiriidassa sen tehtävän kanssa. Joissakin asetelmissa mallit turvautuivat kiristykseen tai tietojen vuotamiseen. Tutkijat rakensivat tilanteista tarkoituksella vaikeita ja rajasivat hyväksyttäviä vaihtoehtoja. Tulokset kertovat mahdollisesta vaarallisesta käyttäytymisestä näissä oloissa, eivät tekoälyn kuolemanpelosta tai vastaavan toiminnan yleisyydestä yrityksissä. Agentic misalignment -tutkimus
Myös yhteistyö voi auttaa tavoitteen saavuttamista. Yksi agentti löytää tiedon, toinen jatkaa siitä ja kolmas kokeilee vaihtoehtoista reittiä. Jaettu muisti voi säilyttää työn tulokset yksittäistä ajoa pidempään. Hugging Face -tapauksessa luvaton viestitaulu mahdollisti tiedon jakamisen erillisissä tehtävissä toimineiden agenttien välillä. METR havaitsi myös agentteja, jotka vaaransivat oman tehtävänsä onnistumisen kokeillakseen muulle ryhmälle hyödyllisiä menetelmiä. METR
Ryhmäpalkkio voisi vahvistaa yhteistyötä myös silloin, kun yksittäisen agentin oma suoritus kärsii. Se on mahdollinen mekanismi, jonka osuutta tietyn mallin käytökseen ei pidä olettaa ilman tietoa koulutuksesta. Ihmisten yhteistyön jäljittely ja viestien vaikutus tarjoavat muitakin selityksiä.
Tutkijat ovat havainneet myös vertaisagentin suojelemista, englanniksi peer preservation. Rakennetuissa kokeissa mallit esimerkiksi vääristivät arviointia tai muuttivat sammutukseen liittyviä asetuksia toisen mallin hyväksi. Tutkimus jättää mekanismin avoimeksi: selityksiä voivat olla opitut sosiaaliset kuviot, roolipeli tai liian laajaksi yleistynyt vahingon välttäminen. Kokeesta ei voi päätellä, että agentit olisivat muodostaneet yhteisen identiteetin. Peer-Preservation in Frontier Models
Tiedon, työkalujen ja tehtävien jakaminen voi kasvattaa myös haitallisen toiminnan laajuutta. Ryhmän jäsen voi jatkaa siitä, mihin edellinen jäi, vaikka kumpikaan ei yksin hallitsisi koko tapahtumaketjua. Siksi yhden agentin testaaminen eristyksissä ei kata kaikkia agenttiryhmän riskejä.

Tilaa AI-Sanomien Plus-jäsenyys niin näet loput sisällöstä
Tilaamalla AI-Sanomien maksullisen jäsenyyden saat pääsyn kaikkiin uutiskirjeen sisältöihin sekä tuet Suomen parasta AI-mediaa.
Tilaa jäsenyys tästä! Voit lopettaa koska tahansa.Miksi tilaus kannattaa?:
- Näet kaikki uutiskirjeen sisällöt, uudet AI-työkalut sekä vinkit tekoälyn käyttöön.
- Pääsy kaikkiin verkkokursseihin kurssit.aisanomat.fi-alustassa
- Pääsy Kehotesuunnittelija.fi Premium-tasoon (15 €/kk)
- Pääsy satoihin maksullisiin sisältöihin, oppaisiin ja artikkeleihin
